重複排除
同一のプロンプトはキーでまとめられます。この実行では12件のリクエストが3回のモデル呼び出しになり、9件の重複は重複排除キャッシュから合計0.3 msで応答しました。
enhanced::Deduplicator
Rust クレート · Tokio · MIT
重複したプロンプトは一度のモデル呼び出しを共有します。プロバイダーが落ちるとサーキットブレーカーが作動し、リクエストは溜まり続けずに即座に失敗します。パイプラインが落としたリクエストはすべてデッドレターキューに入り、中身を確認して再実行できます。Anthropic、OpenAI、llama.cpp、vLLM、自前のバックエンドに対応します。
cargo run --example llm_pipeline4人のユーザーが12件のリクエストで3つの質問をし、その後、擬似的なプロバイダー障害の最中にさらに8件が届きます。点の一つひとつがリクエストで、タイムスタンプはすべて記録した実行のものです。五分の一の速度で再生します。

出典:llm_pipeline_trace.json。内蔵のモックモデル(呼び出しごとに300 ms)でcargo run --example llm_pipelineを実行、デバッグビルド、Windows x86_64。
同一のプロンプトはキーでまとめられます。この実行では12件のリクエストが3回のモデル呼び出しになり、9件の重複は重複排除キャッシュから合計0.3 msで応答しました。
enhanced::Deduplicator
ステージ3のすべてのワーカー呼び出しを包みます。5回失敗すると開き、以降のリクエストはプロバイダーに触れずに拒否されます。60 s後に再び様子を見ます。
enhanced::CircuitBreaker
黙って捨てられるものはありません。チャネルの満杯、タイムアウト、期限切れ、失敗、ブレーカーによる拒否は、すべて理由付きで1000件のリングバッファに入ります。
handles.dlq.drain()
五つのTokioタスクを上限付きチャネル(512, 512, 512, 1024, 512, 256)でつないでいます。モデルが遅いとプロデューサーは待つか負荷を落とすので、高負荷でもメモリは一定のままです。
spawn_pipeline(worker)
このサンプルは約200行で、自前のバックエンドをつなぐテンプレートにちょうどいい作りです。キーを用意してPROVIDER=anthropicまたはPROVIDER=openaiを設定すると、実際のモデルに対して同じ3回の呼び出しを行います。障害はプロバイダーの手前で擬似的に起こすので、費用はかかりません。
耐障害性を担うのはステージ3です。ModelWorkerの周りで期限チェック、サーキットブレーカー、タイムアウトを行います。重複排除、リトライ、キャッシュ、レート制限、負荷分散はワーカーの外側に重ねる部品で、サンプルがDeduplicatorでやっているのとまったく同じ形で使います。

サンプルをクローンして実行します。キーもネットワークも不要です。
git clone https://gitlab.com/mattbusel/tokio-prompt-orchestrator
cd tokio-prompt-orchestrator
cargo run --example llm_pipeline
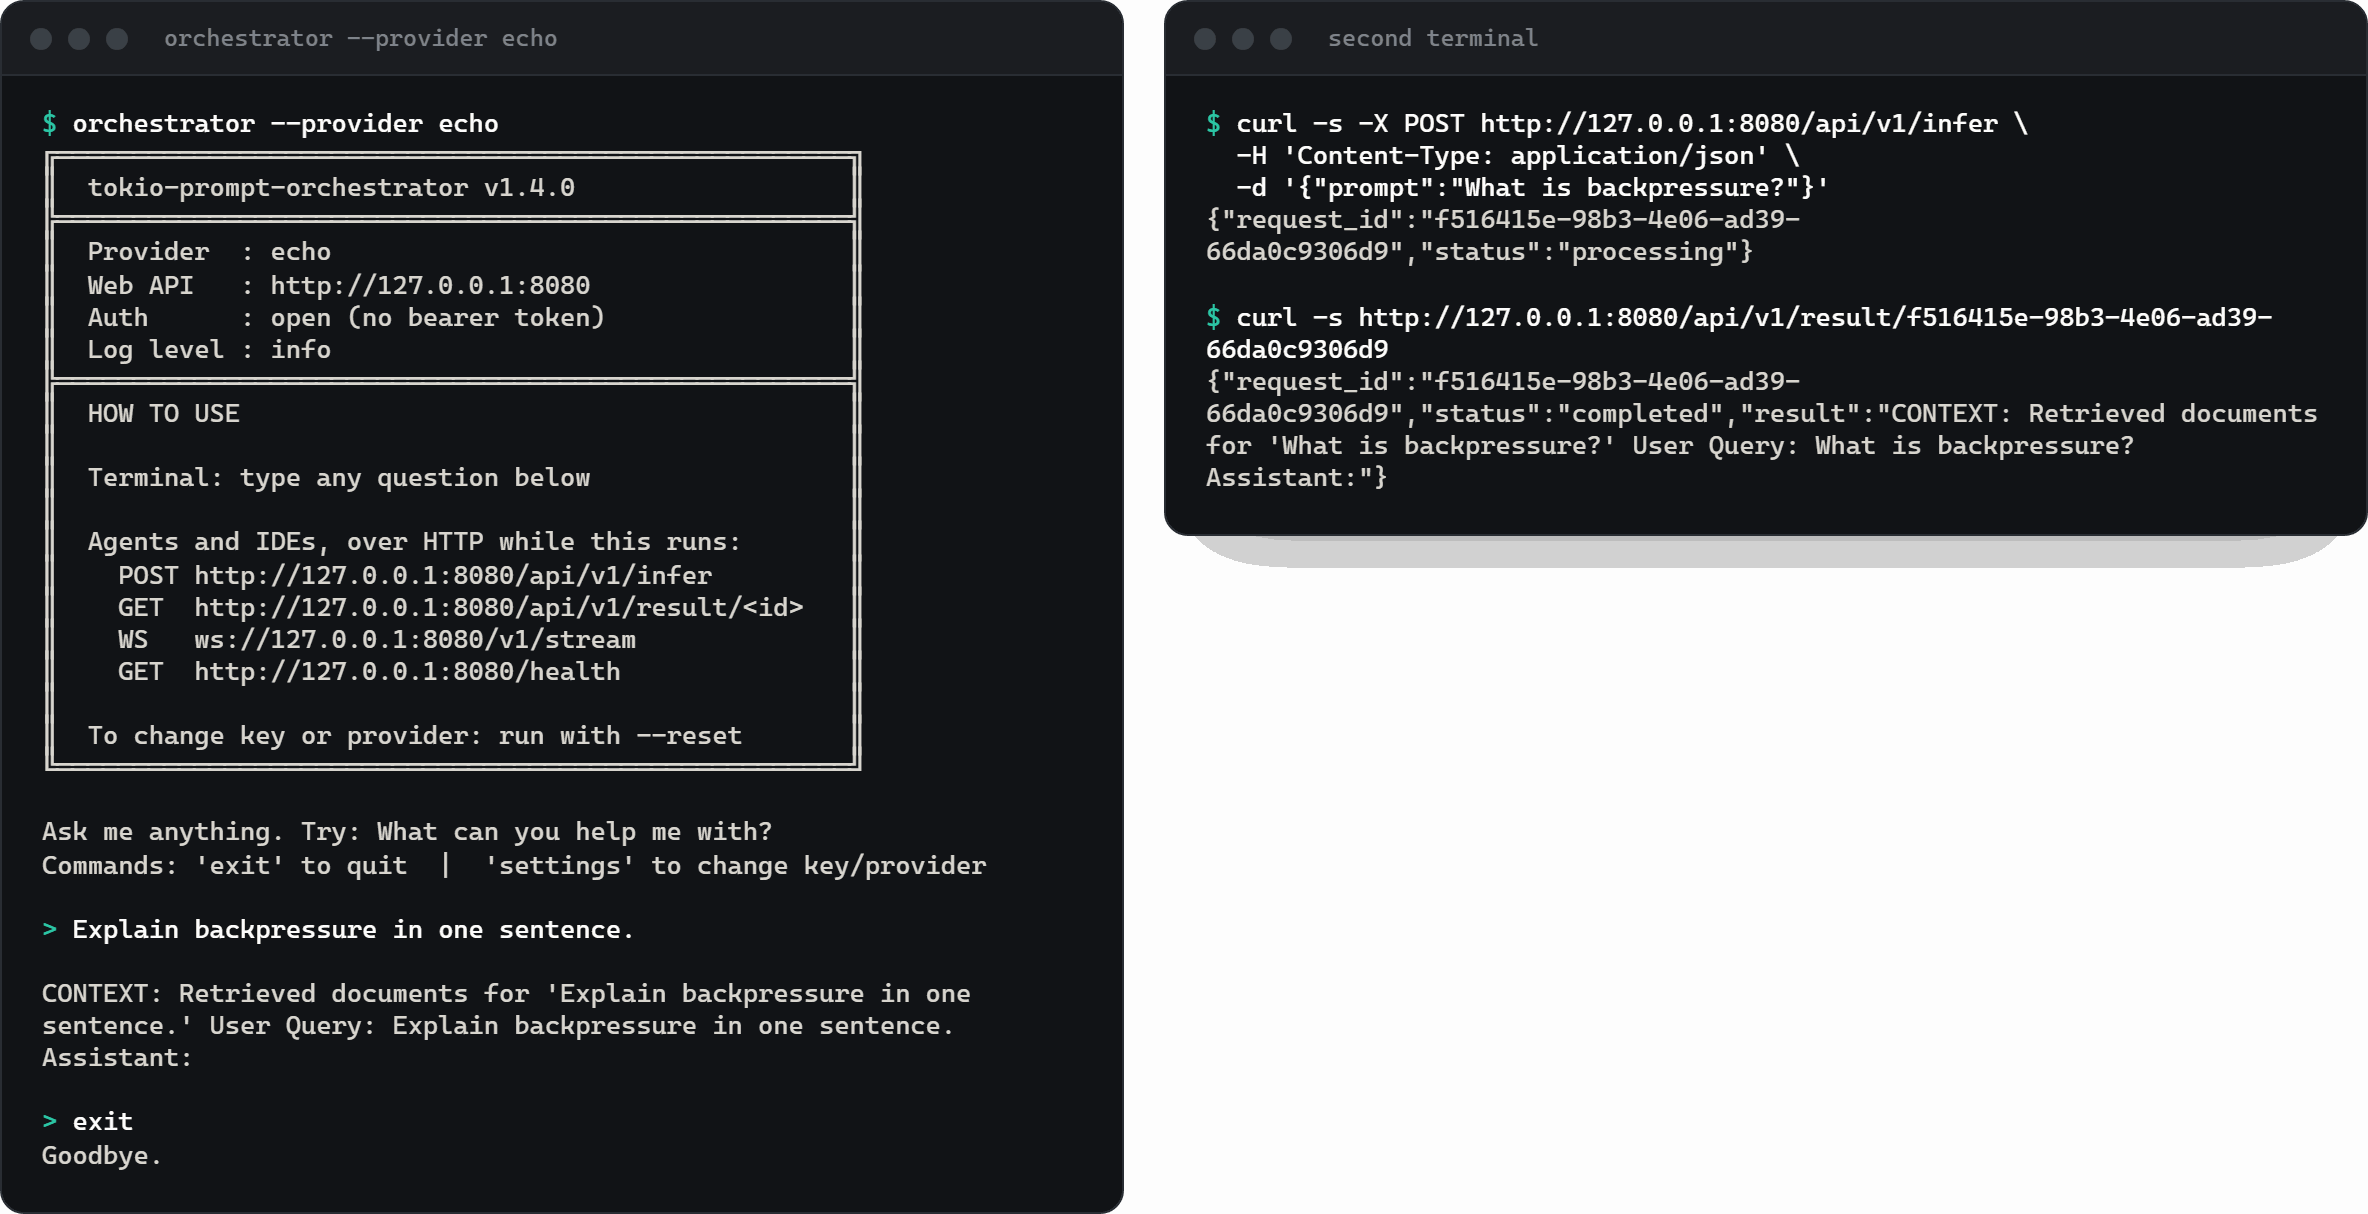
対話型ターミナルと、ポート8080のHTTP API。echoならキー不要です。Windows(PowerShellの一行)、Homebrew、Scoop、cargo binstallについては ダウンロード を参照してください。
curl -fsSL https://gitlab.com/mattbusel/tokio-prompt-orchestrator/-/raw/main/install.sh | sh
orchestrator --provider echo

# then, from another terminal
curl -s -X POST http://127.0.0.1:8080/api/v1/infer \
  -H 'Content-Type: application/json' \
-d '{"prompt":"What is backpressure?"}'EchoWorkerをAnthropicWorker、OpenAiWorker、LlamaCppWorker、VllmWorkerのいずれかに差し替えます。
[dependencies]
tokio-prompt-orchestrator = "1.4"
tokio = { version = "1", features = ["rt-multi-thread", "macros"] }use std::{collections::HashMap, sync::Arc}; use tokio_prompt_orchestrator::{spawn_pipeline, EchoWorker, ModelWorker, PromptRequest, SessionId}; #[tokio::main] async fn main() -> Result<(), Box<dyn std::error::Error>> { let worker: Arc<dyn ModelWorker> = Arc::new(EchoWorker::new()); let handles = spawn_pipeline(worker); let mut output = handles.take_output_rx().await.ok_or("output taken")?; handles.input_tx.send(PromptRequest { session: SessionId::new("demo"), request_id: "req-1".into(), input: "Hello, pipeline!".into(), meta: HashMap::new(), deadline: None, }).await?; if let Some(out) = output.recv().await { println!("{}", out.text); } for dropped in handles.dlq.drain() { println!("dropped {}: {}", dropped.request_id, dropped.reason); } Ok(()) }
orchestratorバイナリは、ターミナルのプロンプトとREST、SSE、WebSocket APIを並行して動かします。プロンプトをPOSTしてリクエストIDを受け取り、結果を取得します。/healthはブレーカーの状態とキューの深さを返します。
Claude DesktopとClaude Codeは、別のmcpバイナリを介してstdioで接続します:MCPの設定
Windows:.exeをダウンロードしてダブルクリック。セットアップでechoを選べば、キーなしで試せます。
モデルごとのスライディングウィンドウとトークンバケット。毎分10リクエストに制限したときの実際の出力:
req-01 ok
...
req-10 ok
req-11 throttled: sliding window limit exceeded; window resets in 60001 ms
req-12 throttled: sliding window limit exceeded; window resets in 60001 ms
rate_limiter::RateLimiterRegistry
Anthropic、OpenAI、llama.cpp、vLLMのワーカー、オフラインのEchoWorker、ラウンドロビンや最小負荷のプール向けのLoadBalancedWorker。それ以外はasync traitを一つ実装するだけです。
trait ModelWorker
キューの深さ、ブレーカーの状態、重複排除による節約、ログパネルをRatatuiのTUIで表示します。モックデータモード付きなので、パイプラインを動かさなくても見た目を確認できます。
cargo run --bin tui --features tui
feature flagでPrometheusメトリクス、OpenTelemetryトレーシング、Redisを使った分散重複排除、プロンプトテンプレート、A/Bテスト、自動チューニングの制御ループを追加できます。デフォルトのビルドにはオプションの依存関係は含まれません。
--features full
BENCHMARKS.md に記録された最新の実行結果です(Windows、x86_64、EchoWorkerのため、ネットワークやモデルの時間は含みません)。
| 計測項目 | p50 |
|---|---|
| レートリミッターのチェック | 110 ns |
send_with_shed (負荷を落とす非ブロッキング送信) | 204 ns |
| サーキットブレーカーのチェック(閉状態) | ~0.4 µs |
| 重複排除のチェック(キャッシュ済み) | ~1.5 µs |
| 同一プロンプト100件を同時送信、重複排除あり、推論は一回 | 合計 52.6 µs |
EchoWorkerの同時呼び出し1000回 | 合計 7.1 ms |